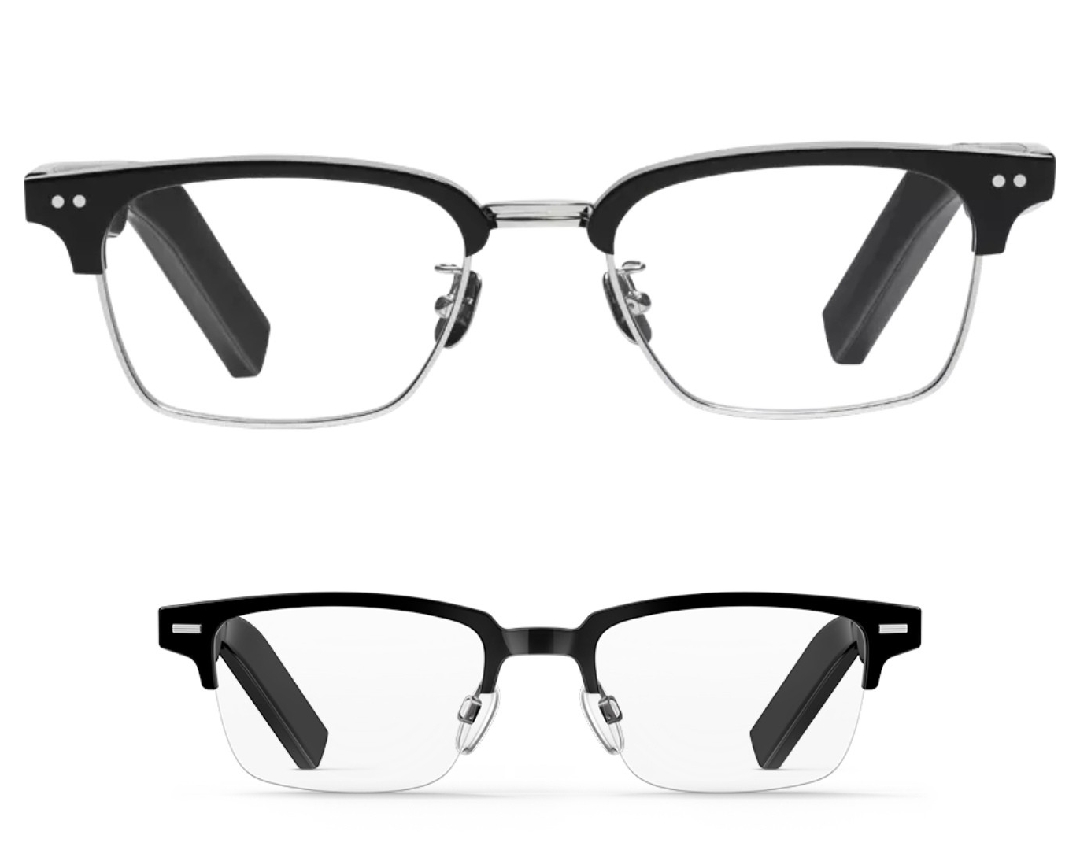
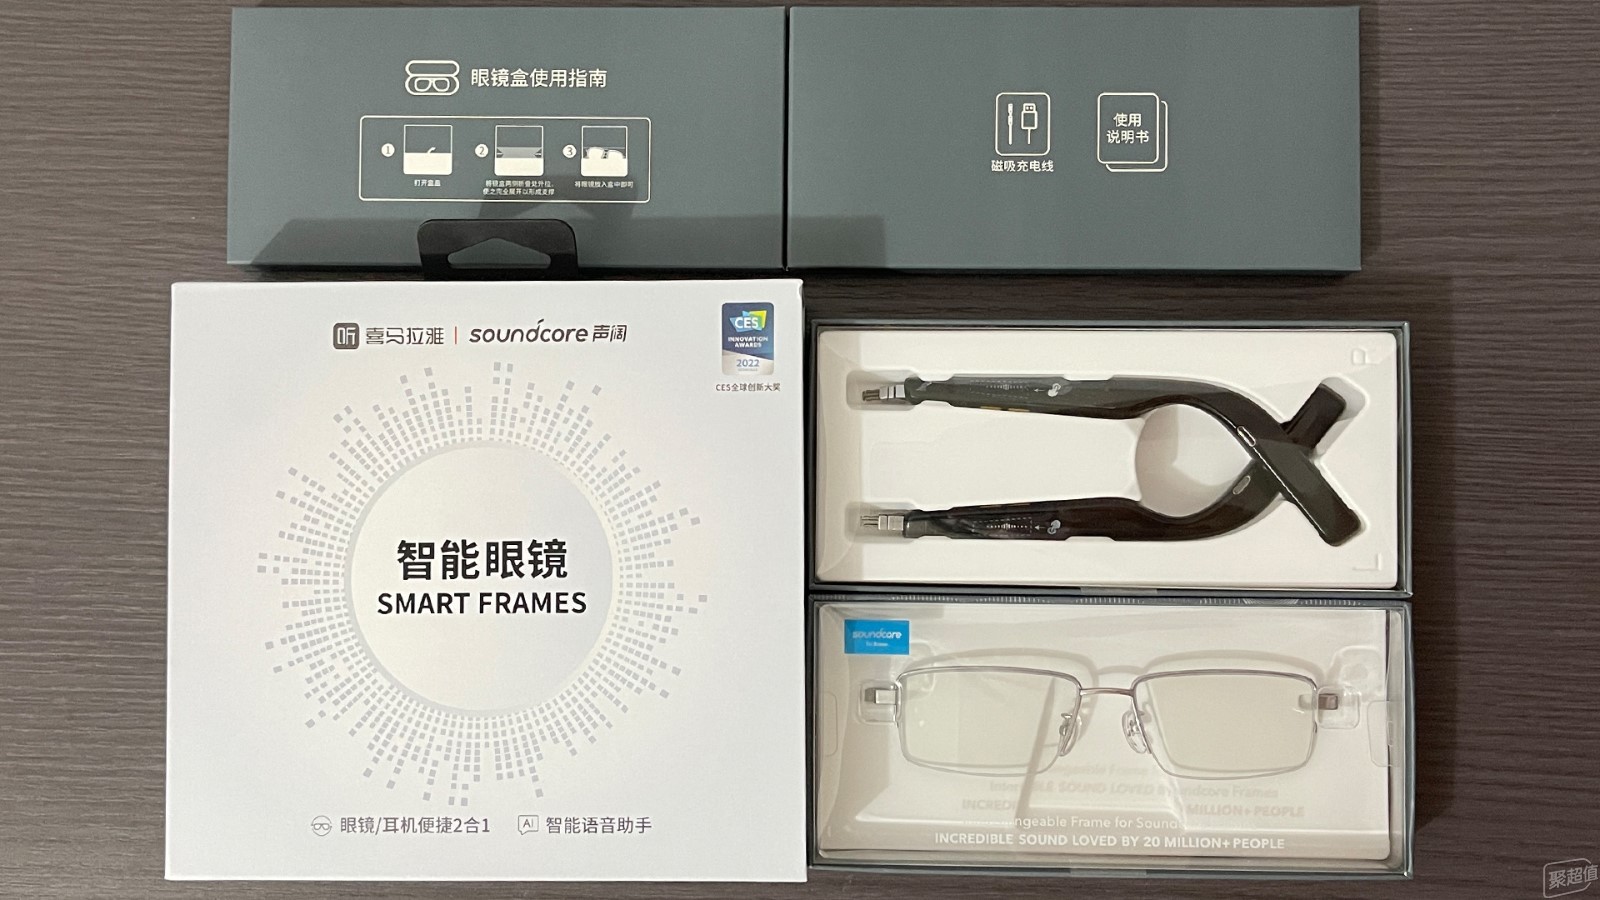
以耳代目 智能眼镜如何为视障人士'读'出世界
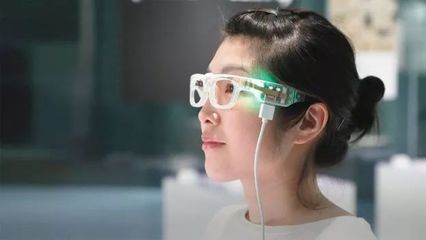
对于视障人士而言,阅读一份菜单、辨认药品包装上的说明,或是核对公交站牌上的线路信息,往往是日常生活中难以回避的挑战。日本研发的一款智能眼镜产品将文字识别与音频合成技术集成于可穿戴设备之中,试图以'以耳代目'的方式,为视障群体提供一种更自然、更独立的信息获取途径。这一技术动向不仅关乎硬件创新,更触及无障碍科技如何真正融入日常场景的核心命题。
从技术原理来看,这类智能眼镜的核心能力在于'看见—理解—朗读'的实时闭环。眼镜前端的微型摄像头捕捉视野中的文字图像,内置的AI识别引擎在本地完成光学字符识别(OCR),将图像中的字符转化为数字文本,再经由语音合成系统以自然语速输出音频。整个过程通常在数秒内完成,用户只需将视线对准目标文字,即可通过骨传导耳机或开放式扬声器听到朗读内容。日本在该领域的研发特色在于对'即时性'和'场景适配'的高度重视:针对日语中汉字、平假名、片假名混排的复杂排版,识别算法做了专门优化;同时考虑到视障人士在行走中使用的需求,设备往往配备轻量化镜架和触控或语音唤醒机制,减少操作负担。
技术可行性并不等同于使用价值。智能眼镜能否真正成为视障人士的'福音',取决于它在真实生活场景中的表现。在光线不佳的室内、文字倾斜或手写的票据、多语言混杂的电器说明书等条件下,OCR的准确率仍会打折扣。更重要的是,视障人士的实际需求远不止'朗读文字':他们需要判断前方是台阶还是平地,需要知道公交是否到站,需要在超市货架前快速定位目标商品。若智能眼镜仅停留在文字转音频层面,其功能便容易被智能手机上的同类应用所替代——后者同样可以拍照识字、朗读文本,且成本更低。因此,这类产品的竞争力在于能否通过始终佩戴、免手操作的形态,将文字识别与障碍物提示、场景描述等能力整合为连贯的辅助体验。
从更宏观的视角看,智能眼镜的兴起也为无障碍设计提供了新的思路:与其为视障群体单独构建封闭的辅助设备体系,不如将通用的AI感知能力嵌入日常物品,让辅助功能'隐形'地存在于普通人的生活场景之中。日本企业在精密光学与小型化方面的积累,使这类产品具备了量产落地的可能性,这本身就值得关注。但要让'福音'名副其实,研发者还需与视障社群深度协作,在噪声环境下的语音清晰度、误识别后的纠错方式、电池续航与佩戴舒适度等细节上持续打磨——毕竟,一项辅助技术是否成功,最终评判标准只有一个:它是否让使用者在不必求助于人的情况下,多获得一分掌控生活的从容。